Echo Music 背后的工程哲学:一个音乐聚合器如何把体验做到"够用又不浪费"
| 项目 | 内容 |
|---|---|
| 软件 | Echo Music |
| 版本 | 5.2.87 |
| 平台 | Android APK |
| 体积 | 63.65M |
| 分类 | 生活休闲 |
| 包名 | iad1tya.echo.music |
| 官网 | Echo Music 官网 |
| 下载一 | Echo Music 下载,Echo Music 下载 |
| 下载二 | Echo Music 下载,Echo Music 下载 |
| 文档 | Echo Music 文档 |
| 介绍 | Echo Music 把分散的音乐资源整合到一个播放器里,但真正让它好用的是那些看不见的设计取舍——歌词拉取策略、数据节省模式、环境音识别的联动逻辑,每一处都是在"极致"和"够用"之间找平衡。 |
Echo Music 是什么,它解决了什么问题
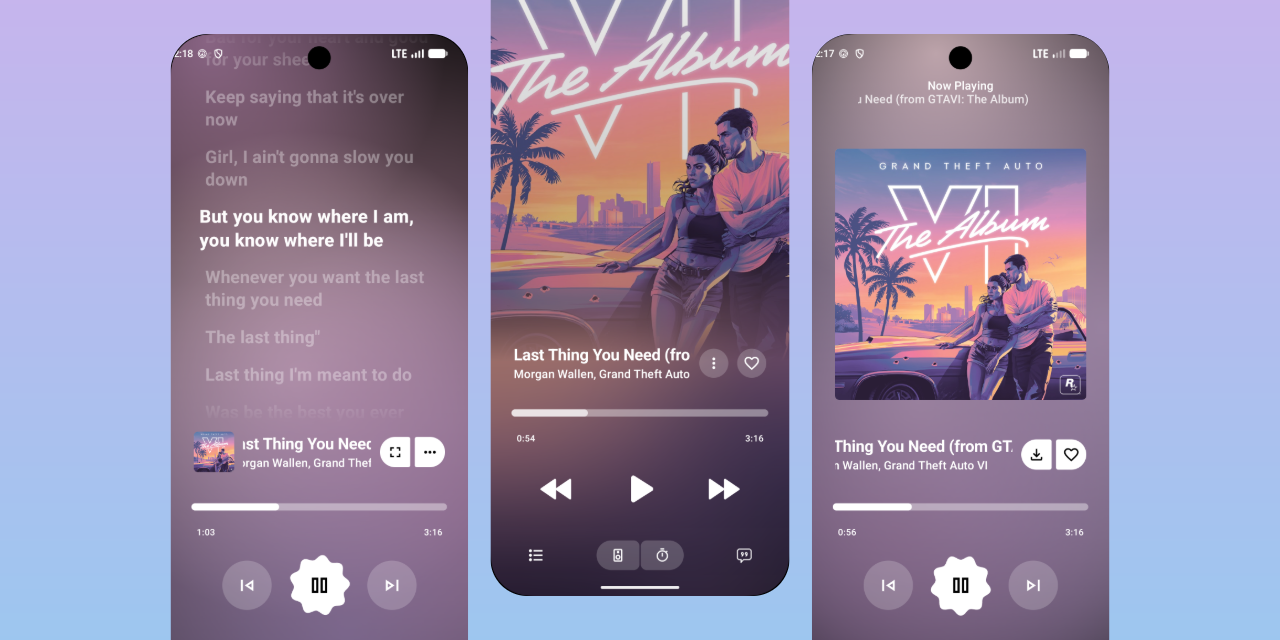
先说人话:Echo Music 是一个跑在安卓上的音乐播放器,它背后接的是 YouTube Music 的曲库,但做得比官方客户端更"懂用户"——歌词更准、识别更快、流量更省,还能离线下载。简单说,它是在"已有海量曲库"这个底座之上,重新打磨了一遍播放体验的每个细节。
但我今天想聊的不是功能清单,而是一个更有意思的问题:为什么 Echo Music 在每个细节上的设计都显得那么"克制"? 它不堆功能、不做花哨的界面动画、不要求用户登录,而是把精力放在了一些别人可能觉得"不值得深究"的环节上——歌词怎么拉、流量怎么省、识别怎么联动推荐。
把这些设计串起来看,你会发现 Echo Music 背后有一套相当清晰的工程哲学:在体验的关键路径上做精细控制,在非关键路径上尽量轻量化。 具体来说就是:用户高频触达的环节(播放、歌词、下载)要做到位;低频或可选的环节(社交、个性化推荐的冷启动)宁愿简单一点也不增加复杂度。
歌词为什么要做三层拉取,而不是单源直取
先看歌词系统——这是 Echo Music 相对官方客户端最被高频提到的差异化优势。它的做法是:
- 先试 Lyrics+(开发者自己运营的新歌词库)
- 没拿到或质量不够就退到 lrclib
- 还不行再试 Better Lyrics
- 三者都没返回就显示「暂无歌词」
然后还有一套质量判定:时间戳覆盖率不到 80% 降级、内容极短或极长直接丢、艺人对不上全部丢弃。拉到的歌词还会做本地缓存,下次直接用缓存不发请求。
这个设计让我想起小区里的快递柜——不是只放一个柜子,而是有快有慢三个柜子:最常用的放最顺手的位置,不太常用的放远一点的,实在没有的就告诉你"今天没有"。关键是它还做了一个"验货"动作,不是随便来一个快递就放进去,得看包装是不是完好、地址是不是你家。
为什么不用单源? 因为任何单一歌词源都有覆盖盲区——热门歌三家都有、冷门歌可能只有一家有、老歌儿可能一家都没有。三层回退本质上是在做冗余覆盖,牺牲一点点请求次数换来了显著更高的命中率。
为什么要做质量判定? 这是很多同类工具跳过的一步。直接展示第一个拉到的歌词,省事但经常出现"匹配到别的歌"或"只有两三行"的尴尬情况。Echo Music 的判定逻辑其实很朴素:逐字覆盖率不够就降级、长度异常就丢、艺人对不上全丢——三行规则解决了大部分错匹配问题。
为什么不做手动校准? 开发者明确说过不打算提供歌词时间戳手动微调入口。这个取舍很有意思——如果用户手动微调了,下次更新缓存又会覆盖回来,体验更乱。所以干脆不让用户调,用"播放引擎 + 歌词引擎对齐"的方式从源头解决偏移问题。这背后的判断是:让用户动手校准的成本,比开发者在引擎层面做对齐的成本更高。
数据节省模式:为什么一次调六个维度,而不是只限码率
蜂窝网络下自动省流量,这个功能很多播放器都有。但 Echo Music 的数据节省模式做得特别细——它不是只限码率,而是同时调整六个维度:
| 维度 | 默认行为 | 节省模式下 |
|---|---|---|
| 音频码率 | 尽量拉最高 | 自动降到 128-192kbps |
| 视频 | 自动切换 | 强制只播音频轨 |
| 封面图 | 800x800 以上 | 400x400 缩略图 |
| 歌词 | 三重回退拉取 | 只拉最轻量的一家 |
| 推荐刷新 | 每次播放后刷新 | 缓存更久、刷新频率降低 |
| 首页信息流 | 每天刷新 | 3 天刷新一次 |
一套组合拳下来,每小时能省大约 100MB 流量。
为什么不直接来个"流量模式 = 低码率"就完事了?因为 Echo Music 的开发者显然想过:用户觉得"流量烧得快"不只是音频的问题——视频歌曲一小时能烧 500-800MB,封面图每次都拉高清版在蜂窝下也浪费,歌词三重回退的那两次请求在弱网环境下不仅费流量还拖慢加载速度。
这种"从天花板上拆零件"的思路在工程上叫分层降级——不是一刀切地砍掉某个功能,而是让每个子系统都往"轻"的方向走一步,叠加起来效果就很明显了。而且它做得很聪明:在 Wi-Fi 下自动恢复正常行为,用户甚至感觉不到切换发生了。
类比一下:这就像你开车上了高速,导航自动把空调调小一点、车窗关上、降低风阻、收紧安全带——不是让你别开了,而是让你在当前路况下跑得更高效。
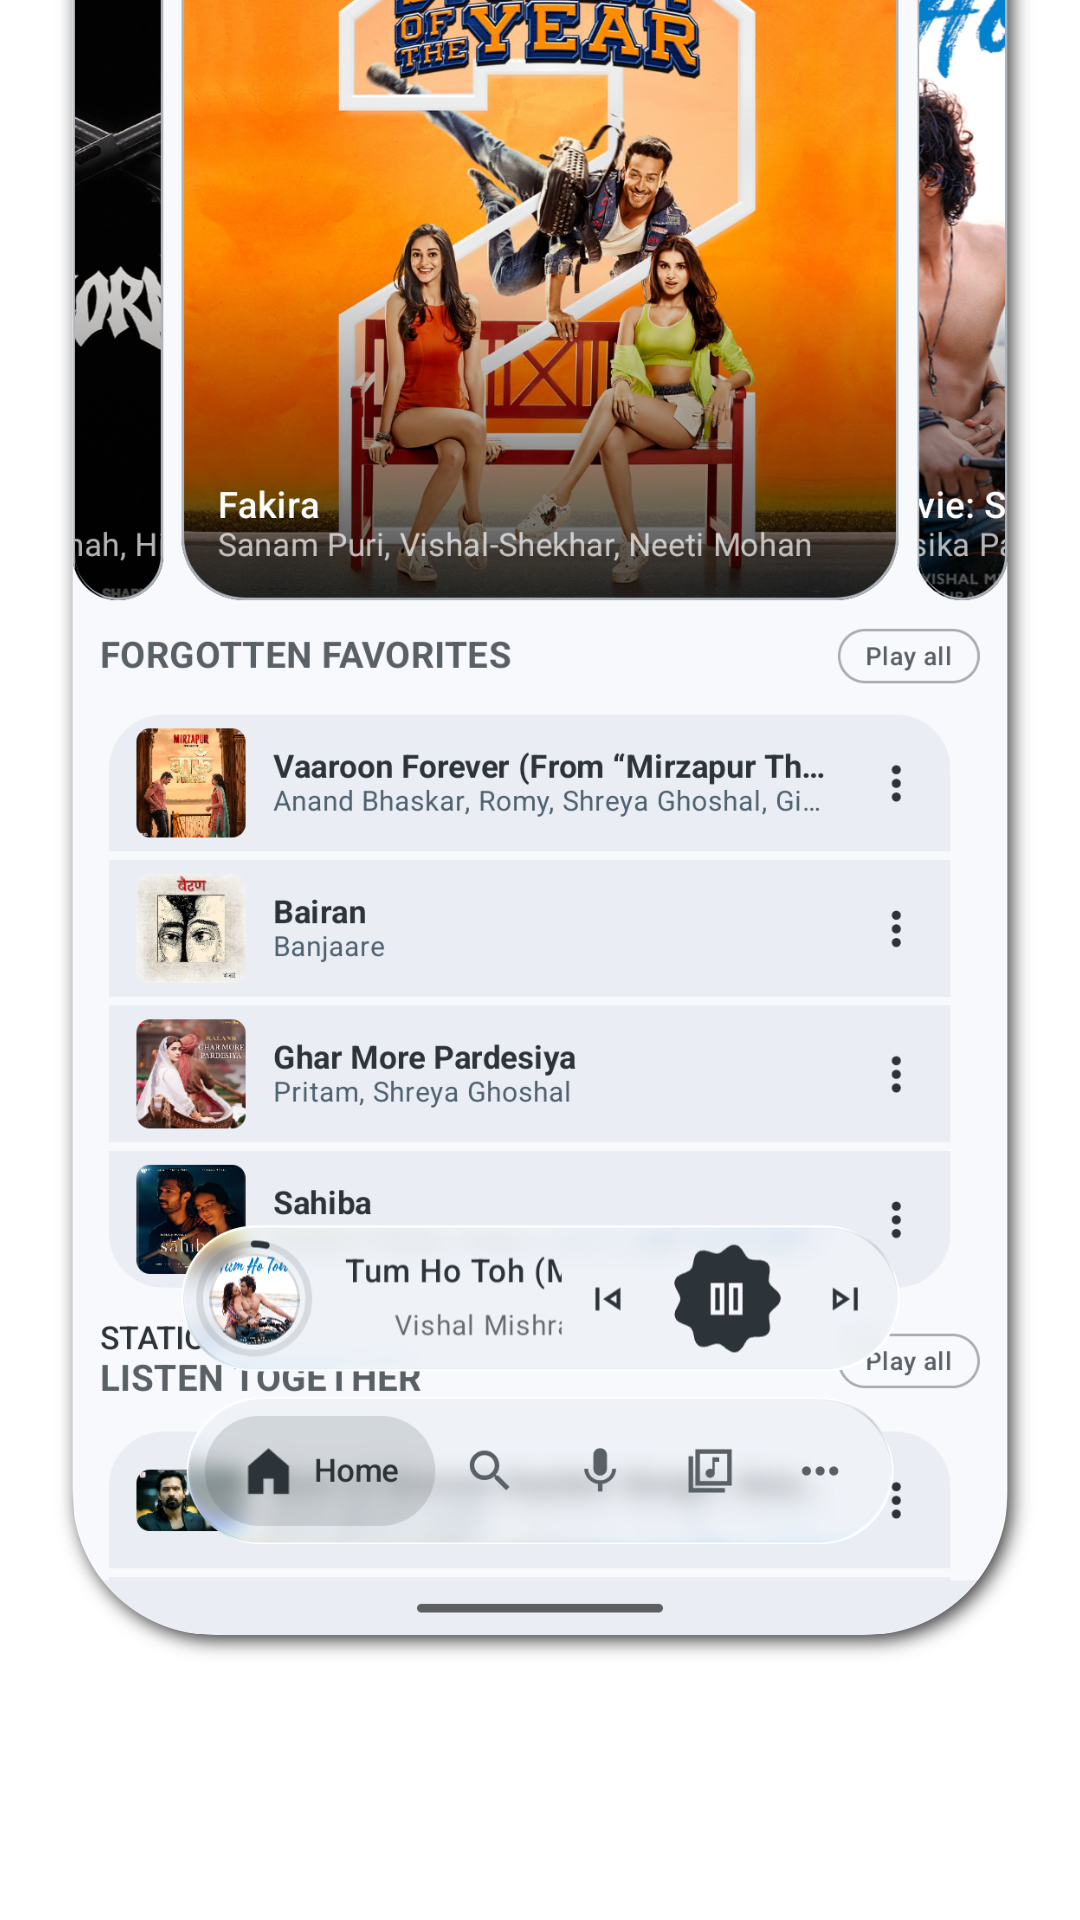
Echo Find:环境音识别如何和推荐系统联动
Echo Find 是 Echo Music 内置的环境音识别功能——对着手机哼几秒就能告诉你这是什么歌。底层技术来自开源项目 MusicRecognizer,识别成功率在热门曲目上能到 95% 以上。
但真正有意思的不是识别本身,而是识别结果如何被用起来。Echo Find 识别出来的歌曲会被标记为"你听过",进入聆听历史;如果识别后你完整播放了它,这个信号会被 Echo Brain 和 Smart Queue 当成偏好的强信号,后续自动推荐同风格的歌。
这个联动设计的妙处在于:它把一个"一次性识别工具"变成了"偏好数据采集器"。传统的识别工具(比如独立的 Shazam 应用)识别完就完了——你得手动点"添加到播放列表"才能让这首歌进入你的音乐生活。而 Echo Find 是被动的:识别、标记、进入历史、影响推荐——整条链路自动完成,用户什么都不用做。
代价是什么?开发者在隐私说明里写得很清楚:识别数据实时传输到云端 API 做匹配,用完就销毁不持久化存储。但在你主动使用 Echo Find 的那几秒钟里,音频确实被发到了云端。这个取舍很典型:用几秒钟的隐私暴露换来了更智能的个性化推荐。 你接受不接受,取决于你觉得这个联动值不值。
歌单下载:静态和动态为什么区别对待
Echo Music 里有三种歌单:自建歌单、从 YouTube Music 导入的歌单、系统智能生成的歌单(Smart Queue、Echo Brain 推荐、心情频道)。前两种可以一键下载整单,第三种不行。
原因很简单:前两种是静态快照——歌单里的曲目相对固定,你点"下载歌单"就是把当前这个快照批量下载下来。而第三种是动态生成的——内容随时间和你的聆听习惯变化。如果允许一键下载智能歌单,下的就是某个时刻的临时快照,过几天歌单变了,你下载的内容就过时了。
所以 Echo Music 的设计是:智能歌单不支持整单下载,但里面每首歌可以单独下载。这样你下载下来的是你真正想要的,而不是某个时刻的临时推荐快照。
这个取舍体现了一个很实用的工程原则:不要为了用户可能偶尔需要的功能,去增加系统的复杂度。 一键下载智能歌单听起来很方便,但背后涉及到快照冻结、快照过期清理、快照和智能歌单的同步冲突等一系列问题。让用户手动挑感兴趣的歌下载,虽然多了一步操作,但系统层面干净多了。
这套设计哲学意味着什么
把上面几个点串起来,Echo Music 的工程哲学可以用一句话概括:在高频路径上做精细控制,在低频路径上保持简单。
歌词三层拉取 + 质量判定是高频路径——每次播放都要用,所以值得花功夫打磨。数据节省模式六个维度同时调是高频路径——蜂窝网络每天都可能触发。Echo Find 和推荐系统联动是把低频操作(偶尔用一次识别)转化为高频收益(持续影响推荐质量)。
而智能歌单不做一键下载、不做歌词手动校准、不强制登录——这些都是在低频或争议性路径上选择了简单方案,避免增加复杂度和维护成本。
那这套设计适合什么场景?适合那些对"体验一致性"敏感、但又不想被功能淹没的用户。 如果你每天用同一个播放器听几个小时,你会明显感觉到这些精细控制带来的体验提升——歌词更准了、流量更省了、识别完的歌自然进了推荐池。但如果你只是偶尔用一下,可能根本注意不到这些细节,这时候 Echo Music 和其他播放器的区别就不那么明显了。
至于这套设计的代价?最明显的是冷启动成本——Echo Brain 推荐需要积累聆听历史才能变得精准,歌词缓存需要拉几次之后才能稳定,离线库需要花 Wi-Fi 时间下载。它不是一个"装完就能用得爽"的播放器,而是一个"用得越久越顺手"的播放器。这可能就是 Echo Music 团队故意做的取舍:用一点耐心换长期的体验收益。
本文为个人基于网络公开资料整理编写,非官方内容,仅供学习交流参考;软件版权归原作者所有,请支持正版;使用过程中遇到问题请查阅官方渠道,本文不承担任何责任。