Keep 為什麼把「身體年齡」放在首頁:拆解這款運動 App 的 AI 資料架構
Keep 在 9.1 版新增了「身體年齡解析」,這背後是一套從運動表現到評估結論的 AI 運算鏈。本文拆解它的資料流、設計取捨與適用場景,說清楚為什麼同樣是記步數,Keep 能算出一個你讀得懂的數字。
Keep 是一款把運動資料壓縮成結論的 App
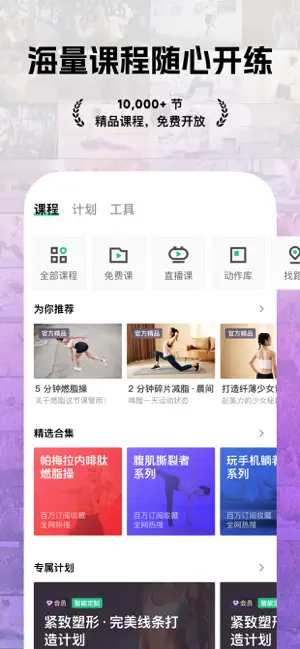
Keep 是北京卡路里科技開發的綜合性運動健康平台,支援多種健身方式識別、個性化訓練計劃、動作語音指導與食物熱量查詢。從表面上看,它提供的功能和同類軟體差不了太多——課程跟練、跑步記錄、飲食日記,這些板塊幾乎每款運動 App 都有。真正讓我感興趣的是,Keep 在 9.1 版新增了「身體年齡解析」:它把你的有氧能力、力量表現、身體成分等多項輸入壓縮成一個直觀數字——「你的身體相當於多少歲」。
這件事乍看像是一個營銷噱頭,但拆解之後會發現,它其實是 Keep 整體產品架構的縮影:從 GPS 追蹤、課程跟練、體脂秤、手環等多源收集資料,經過一套統一的運動檔案系統存儲,最後用 AI 模型把分散的指標翻譯成一個普通人讀得懂的結論。這個「把複雜指標翻譯成人話」的設計思路,貫穿了 Keep 的多個核心功能,而它的代價和適用邊界,也藏在同一套架構裡。
安裝
Keep 提供 Android APK 安裝包,最新版本為 8.7.40,安裝包大小約 132.88M。這個體積在運動類軟體裡屬於中等偏上——主要是因為內建了大量課程影片預覽素材與動作識別模型的本地資源,首次啟動時仍需下載部分完整課程資源包,建議在 Wi-Fi 環境下完成。安裝流程與一般 Android App 無異:Keep下載 APK 後允許安裝未知來源應用即可。首次啟動時會引導註冊帳號或綁定第三方登錄,接著進入簡單的身體參數問卷(身高、體重、運動基礎),這些資料會作為後續 AI 評估的基線。需要注意的是,Keep 的部分進階功能(如 AI 教練排程、身體年齡解析)要求版本在 9.1 以上,如果你的裝置因系統版本過低無法更新,這兩項功能會自動隱藏但不影響基礎課程跟練與跑步記錄。
問題:為什麼同樣記步數,Keep 能算出一個你讀得懂的數字
大多數運動 App 的資料展示停留在「原始指標層」——今天跑了 5.3 公里、消耗 320 千卡、心率峰值 145 bpm。這些數字對有經驗的跑者來說有意義,但對一個剛開始運動的普通用戶,「5.3 公里」是快是慢、「320 千卡」算多還是少,沒有参照就無法判斷。
Keep 的「身體年齡」解決的正是這個問題:它把多項身體表現壓縮成一個與實際年齡對照的數值。官方的說法是「從體能和運動表現出發,幫助你了解自己的身體狀態」。這個數值不是單一指標的換算,而是有氧能力、力量表現、身體成分等多維度資料的綜合估算。對用戶來說,「身體年齡 32 歲、實際年齡 35 歲」比體重、體脂率、最大攝氧量這些專業詞彙加在一起還要直觀——不需要任何運動科學背景就能讀懂結論。
拆解:Keep 的資料流與 AI 架構
從輸入到輸出,這套系統大體分為四層:
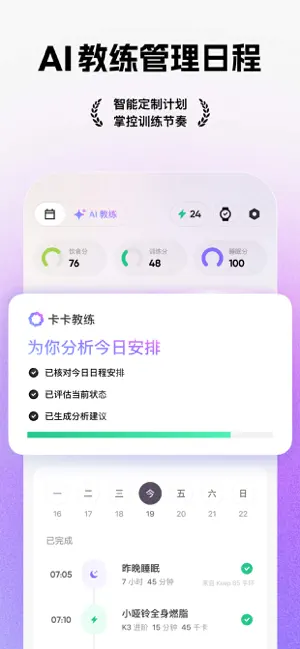
第一層是多源資料收集。 Keep 的資料輸入不止手機本身的傳感器。跑步時 GPS 提供軌跡與配速,課程跟練時手機的加速度計和陀螺儀捕捉動作節奏,連接體脂秤後提供體脂率與肌肉量,連接手環後補齊靜態心率與睡眠資料。9.1 版起,AI 教練的訓練計劃執行情況也會反饋回資料池。每一個資料來源的精度不同、取樣頻率不同,最終都要匯入同一個運動檔案。
第二層是統一運動檔案的設計。 這是 Keep 和多數同類產品的關鍵差異。很多 App 把跑步資料、課程記錄、體重變化分散存儲,用戶在不同頁面看到的是孤立的數據點。Keep 的做法是把所有運動行為都掛在同一個時間線上——不管是跟練了一節 K3 課、跑了 5 公里、還是記錄了一餐飯的熱量,最終都對應到同一個用戶檔案的同一條時間序列。這種設計讓跨類型的關聯分析成為可能:AI 教練可以根據「你上週二跟練 K3 後心率恢復速度偏慢」來建議本週降一檔難度,而不是單純看你有沒有完成目標。
第三層是課程難度的標籤化體系。 K1 到 K5 的五級難度不是隨便定的。K1 是入門級、動作簡單、幾乎無跳躍;K5 是頂級難度、高強度間歇、爆發力動作密集。配合 HIIT、Tabata、燃脂、塑形、拉伸等功能標籤,每節課都有一個可機器讀取的屬性集合。這些標籤一方面幫用戶快速篩選適合的課程,另一方面也讓 AI 教練可以根據用戶的歷史表現做精準匹配——如果一個用戶連續三次完成 K3 課程且心率恢復良好,系統就會自動推薦 K4 的內容。
第四層是輸出層的 AI 翻譯器。 身體年齡是這一層最典型的產物。它的輸入是運動表現(有氧能力從跑步記錄估算、力量表現從課程跟練的動作完成度反推)、身體成分(體脂秤或手環資料)、訓練頻率與持續時間。模型把這些變量輸入後,輸出一個「身體狀態相當於多少歲」的估算值。值得注意的是,官方(完整功能說明見 Keep文檔)從未完全公開算法細節——這是所有 AI 健康指標的共同特點:模型需要大量用戶資料訓練,而公開公式會讓數據造假(如刻意調快 GPS 模擬高強度)變得容易。
用一個生活化的類比來說:Keep 的架構就像一個醫院的檢驗系統——第一層是各種檢查設備(抽血、照超音波、量血壓),第二層是把所有檢查報告歸檔到同一個病歷,第三層是給每項檢查結果加一個正常範圍的標籤,第四層是醫生看完整份病歷後給你一句結論「身體狀態良好」,而不是把所有化驗數據丟給你自己看。Keep 把「醫生」這個角色部分交給了 AI。
取捨:這套設計的代價與失效場景
沒有架構是完美的,Keep 的資料驅動設計有三個明顯的代價。
第一個代價是安裝包體積。132.88M 的 APK 在同類產品裡不算輕,主要原因是課程預覽素材和動作識別模型的資源要隨安裝包一起下發。用戶首次啟動後仍需下載完整課程資源包,對於手機存儲空間緊張的用戶來說是個門檻。
第二個代價是模型估算的偏差。官方自己也承認,同一天兩次測量身體年齡可能有浮動——這是因為模型的輸入本身就有噪音:GPS 在城市高樓區會漂移,體脂秤在不同時間測量有 3%~5% 的波動,課程跟練時手機的擺放位置會影響動作識別精度。模型的輸出是概率估算而非醫學檢測,單次值的參考性有限,趨勢(每兩四周看一次變化方向)才有意義。此外,官方未公開算法意味著不同用戶之間也不宜直接攀比——一個累積了半年資料的用戶和剛用兩週的用戶,即使得出相同的身體年齡,口徑也是不同的。
第三個代價是冷啟動問題。剛下載 Keep 的新用戶,運動檔案幾乎為空,此時 AI 教練推薦的課程和身體年齡的估算都偏粗糙——系統需要至少兩到三週的持續記錄才能形成一個有參考價值的個人資料庫。這對新用戶來說是個雞生蛋蛋生雞的問題:你需要先堅持一段時間,AI 才能給你有針對性的建議,而多數人剛開始運動恰恰最缺乏方向。
判斷:這套原理意味著什麼
Keep 的架構設計告訴我一件事:如果你是那種「有計劃地堅持運動」的用戶——願意每天記錄飲食、每次跟練課程、連接手環和體脂秤——Keep 的價值會隨著你的使用時間指數級上升。運動檔案越完整,AI 教練的推薦越精準,身體年齡的估算越可靠,訓練計劃的調整越個性化。
但如果你只是偶爾跑跑步、從不記錄飲食、也不連接任何外部裝置,Keep 對你來說和任何一款能記步數的 App 差別不大——AI 模型再強,沒有足夠的輸入也產不出有價值的輸出。這不是產品的問題,而是所有資料驅動型服務的共同邊界:垃圾進、垃圾出。
最後回到那個問題:Keep 為什麼把「身體年齡」放在首頁?因為它是 Keep 架構哲學的標誌性產物——把分散的運動資料壓縮成一個普通人讀得懂的結論。對多數運動 App 來說,用戶看到的是儀表板;對 Keep 來說,用戶看到的是一個答案。至於這個答案準不準、值不值得信,取決於你自己往那個資料池裡倒了多少東西。
本文为个人基于网络公开资料整理编写,非官方内容,仅供学习交流参考;软件版权归原作者所有,请支持正版;使用过程中遇到问题请查阅官方渠道,本文不承担任何责任。