PaperYY 查重引擎深度拆解:共享自建庫與語義降重的技術取舍
從 500 萬+ 共享自建庫機制到第三代語義降重模型,這篇文章把 PaperYY 背後的技術設計講明白,解釋它為什麼能在學生圈快速獲客。
PaperYY 是什麼
PaperYY官網 是一款專注於學術論文查重與降重的手機應用,面向學生、教師和科研工作者。它的核心能力很直接:上傳論文 → 檢測重複率 → 輸出帶顏色標註的報告 → 提供自動降重或人工降重通道。從 2020 年上線以來,它在中國大陸高校的學生群體中積累了相當可觀的用戶量,尤其是在畢業季前的查重高峰期,服務器壓力峰值能反應出真實的市場滲透率。
這款軟體的定位並不是第一家做查重的廠商——學術查重領域早有同方知網、萬方、維普等重量級玩家。但 PaperYY 巧妙地避開了正面競爭:它不做機構級的深度整合,而是把手機端體驗做到極致,把查重量化為「幾分鐘出結果」的輕量級服務,並通過共享自建庫機制彌補自己對比庫規模不如巨頭的劣勢。對學生來說,這是一個手機上就能完成全部查重流程的方案,不需要開電腦、不需要註冊複雜的機構賬號。
安裝
PaperYY下載 提供 Android APK 安裝包,最新版本為 1.23.1,安裝包大小約 49MB。由於不是從 Google Play 發布的應用,安裝流程需要在手機上放行未知來源權限。具體操作:下載 APK 後點擊安裝,系統會彈出「未知來源」警告,允許本次安裝即可。安裝完成後首次啟動,應用會引導你完成手機號註冊或登入,這個賬號同時關聯網頁端和 APP 端的數據,查重報告、降重記錄、自建庫全部多端同步。
值得注意的是,PaperYY 不需要額外下載模型包或數據庫——對比庫完全在雲端,本地只跑 UI 和上傳下載邏輯。這是它相比同類產品的一個優勢:同樣是查重軟體,有些產品需要用戶預先下載數百 MB 的本地對比庫才能離線工作,PaperYY 則把這部分成本全部轉移到了服務端。當然代價是沒有網路就無法使用核心功能,對比庫也無法自定義本地擴展。
查重引擎的核心:共享自建庫是怎麼運作的
現在來拆解它最有意思的技術設計——共享自建庫。官方首頁把「獨有 500 萬+ 共享自建庫」當成核心賣點,PaperYY文檔 對這個機制有完整的解說,但多數用戶只知道開關按鈕、不知道這 500 萬是怎麼來的。
機制其實很簡單:PaperYY 的每個用戶都可以上傳自己的參考文獻到「自建庫」,然後選擇要不要共享。共享之後,這批文獻就進入了一個公共池子,所有開啟共享的用戶在查重時都能調用這批文獻參與比對。與此同時,高校或科研機構可以建立「機構自建庫」,由組織內部成員共同維護,這些機構庫同樣可以納入共享池。
把這個機制翻譯成技術語言,就是一個帶有兩層結構的分佈式對比庫:個人層 + 機構層,兩層都可以選擇參與公共共享。查重時系統會同時比對三個來源:官方基礎對比庫 + 用戶自建庫(私密) + 500 萬共享池。這樣做的好處是顯著的——官方對比庫規模有限,但共享池把每個用戶的私人文獻貢獻都變成了公共資源,理論上對比庫規模隨著用戶基數增長而自然擴張。
這裡有一個值得玩味的取捨。共享自建庫的隱私邊界設計得很細緻:即使你開了共享,其他用戶也無法直接查看你上傳的論文原文——共享的是「比對參與度」,不是「原文可見性」。用戶 A 上傳了一篇論文到自建庫並共享,用戶 B 開啟共享後查重,系統會拿 B 的論文和 A 的那篇做相似度計算,但 B 永遠看不到 A 的原文。這是在「鼓勵共享」和「保護隱私」之間找到的一個微妙平衡——它成功解決了用戶對「我上傳的論文不會被別人抄走」的顧慮,這也是為什麼共享池能快速積累到 500 萬規模的原因。
用一個生活化的類比來說:這就像一個圖書館,每個讀者可以把自己的私人書籍捐進館藏,但捐贈之後這本書仍然只存在書架上供人查閱——沒有人能把整本書複製帶走,只能通過館際互借看到目錄和簡介。共享自建庫就是這個圖書館,而隱私邊界就是館規:你能查閱、能比對、但無法獲取原文。
降重不是魔術:三條通道的技術路徑
查重之後的降重環節,PaperYY 提供了三條通道,這三條背後其實是完全不同的技術路線。
第一條是擴寫版機器降重。它的核心策略很粗暴:對標紅段落進行語義擴展,用更多的字把原本的意思鋪開,稀釋重複比例。這個方法的好處是便宜(官方標稱更實惠),適合初稿重複率很高的場景——比如重複率在 25% 以上的論文,擴寫版能快速把大段重複壓下去,讓剩下的工作變得可控。但代價也明顯:擴寫出來的文字很容易出現邏輯鬆散、語義重複的問題,後面還是需要人工再修一遍。
第二條是修改版機器降重,官方稱之為「第三代語義降重模型」。這條路線比擴寫版聰明得多——它不是單純加字減字,而是基於語義理解對標紅段落進行重寫,保持原意的同時替換表述方式。這本質上是一個語義翻譯問題:把同一段話用另一種說法重新組織。從技術角度來說,這需要一個經過學術語料訓練的 seq2seq 模型,能夠識別段落的核心論點、保留關鍵術語、重寫語句結構。這條通道的性價比最高,官方標價 3 元/千字,重複率在 10%-25% 之間的論文用它最合適。
第三條是人工降重,由碩博團隊在線修改。這已經不是技術問題,而是服務問題——它的定位是畢定稿的最後保證,用價格換質量。機器降重不管多先進,終究無法理解論文中的深層邏輯和學術論證,人工降重的核心價值就在這裡。
這三條通道的設計反映了一個清晰的產品思路:讓用戶根據自己所處的寫作階段和預算,選擇合適的技術路徑,而不是強制所有人用同一個方案。初稿階段拼速度和價格,用擴寫版;中後期講究通順度,用修改版;最後定稿不能翻車,交給人工。這種分層設計確實比市面上只提供單一機器降重的產品更貼近學生的真實寫作流程。
顏色標註與報告結構的設計邏輯
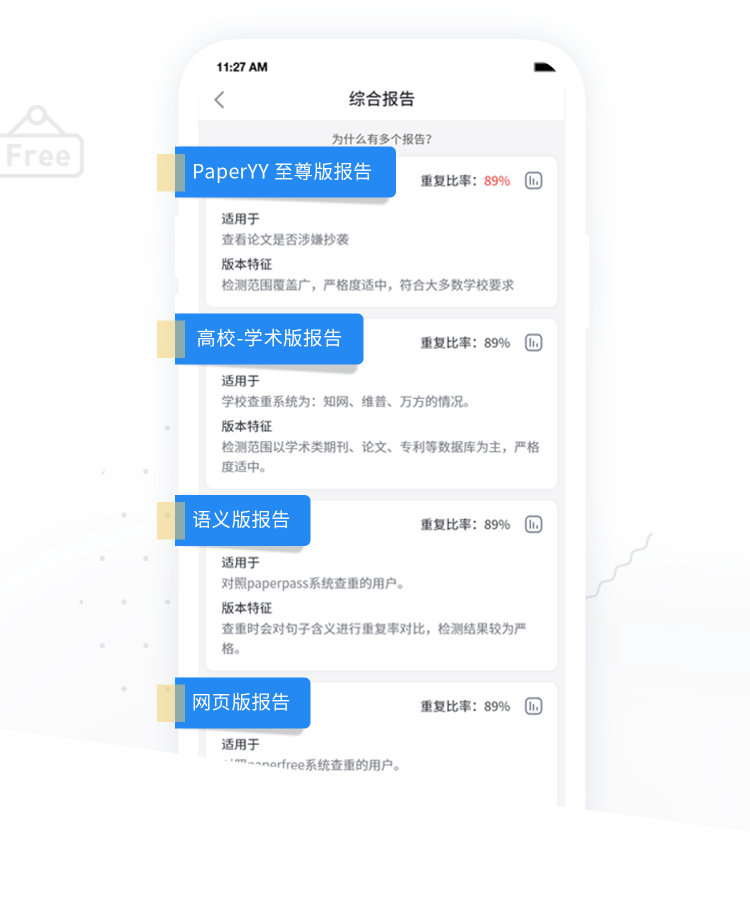
查重報告的四種顏色——紅字(抄襲)、黃字(引用)、灰字(不參與檢測)、黑字(原創)——看起來是個直觀的 UI 設計,但背後其實反映了查重引擎的判斷邏輯。
最有意思的是灰字:系統把不參與檢測的內容自動標灰,這通常包括參考文獻、附錄、致謝等板塊。問題在於,這些內容怎麼被識別出來?官方 FAQ 給了一個線索:如果參考文獻格式規範,系統能自動識別並剔除;如果格式錯亂,系統會把參考文獻當正文來比對,導致大量假紅字。
這說明 PaperYY 的查重引擎有一個前置的「結構識別」層,在真正做相似度比對之前,先試圖理解論文的文檔結構——哪些部分是正文、哪些是參考文獻、哪些是附錄。這個結構識別的準確程度直接影響了後續查重結果的質量:識別準了,參考文獻自動灰掉、不會被誤判抄襲;識別錯了,正文混進參考文獻區、或者參考文獻區被當成正文比對,都會產生大量無效的標紅。
這也是為什麼官方反覆強調「參考文獻格式要規範」——這不是一個寫作規範問題,而是一個技術層面的輸入要求。格式規範了,結構識別層就能正確工作;格式亂了,後面的查重全鏈路都會出錯。從這個角度看,顏色標註不只是給用戶看的結果展示,它也是查重引擎內部處理流程的一個可視化映襯。
本文为个人基于网络公开资料整理编写,非官方内容,仅供学习交流参考;软件版权归原作者所有,请支持正版;使用过程中遇到问题请查阅官方渠道,本文不承担任何责任。