Wan2.2 本地部署避坑:我替你踩过的那些雷
| 项目 | 内容 |
|---|---|
| 软件 | Wan2.2 |
| 版本 | 3.43.2 |
| 平台 | Android APK |
| 体积 | 64.42M |
| 分类 | 摄影图像 |
| 开发商 | 通义云启(杭州)信息技术有限公司 |
| 包名 | com.aliyun.tongyi |
| 官网 | Wan2.2 官网 |
| 下载一 | Wan2.2 下载,Wan2.2 下载 |
| 下载二 | Wan2.2 下载,Wan2.2 下载 |
| 文档 | Wan2.2 文档 |
| 介绍 | 三个月前兴冲冲想本地部署 Wan2.2 搞文生视频,结果前后折腾两周才跑通。看着就是 pip install + torchrun 的事,实际踩了好几个不仔细看文档就必翻的坑。 |
Wan2.2 是什么,能干嘛
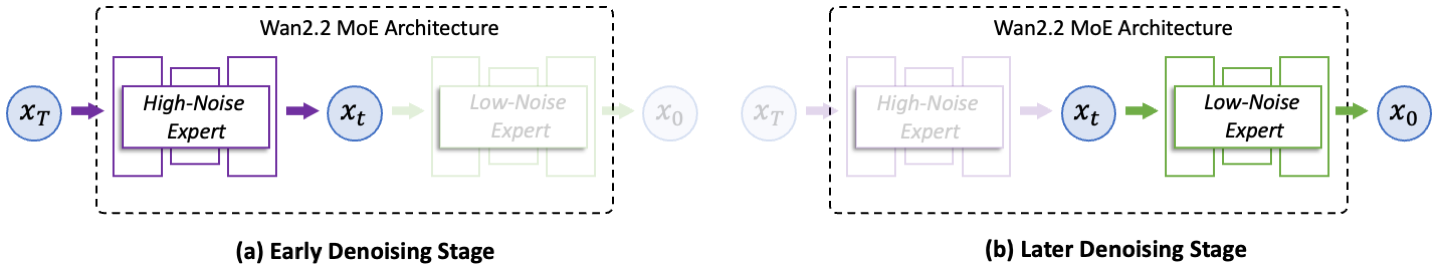
Wan2.2 是阿里通义万相开源的大模型系列,主打图片和视频生成能力。它分好几个型号——TI2V-5B 是基础款,24GB 显存就能跑,A14B 是 MoE 架构的旗舰款,效果好但显存门槛高,还有 Animate-14B 做角色动作复现的。开源之后可以本地部署,也可以用 HuggingFace Diffusers 几行代码集成到自己的项目里。适合谁?手里有 NVIDIA 显卡、想自己跑文生视频、不想每次都调云端 API 的开发者和爱好者。
第一个坑:FlashAttention 装不上
症状:跑 pip install -r requirements.txt 其他包都顺利,唯独 flash_attn 编译报错退出,错误日志翻不到头,最后只给一行 "subprocess-exited-with-error"。
原因:FlashAttention 3 对编译环境要求非常挑剔。它需要匹配的 CUDA 版本、PyTorch 版本,还有完整的 C++ 编译工具链。Linux 上还得装 build-essential,Windows 上需要 Visual Studio C++ Build Tools。更烦的是,如果你一次性装所有依赖,FlashAttention 往往会在其他包之前失败,整个 pip install 直接中断。
解法:官方文档给的建议被我验证过——先装其他所有包,最后单独装 FlashAttention。如果还报错,按这三步排查:
nvidia-smi看驱动版本,torch.cuda.is_available()确认 PyTorch 能识别到 GPU;- 升级 pip、setuptools、wheel 到最新版(
pip install --upgrade pip setuptools wheel); - 还不行就看显卡架构——4090/A100 用 FlashAttention 2 也能凑合,Hopper 架构(H100)才必须 FlashAttention 3。
第二个坑:显存不够硬跑 A14B
症状:命令一敲,模型加载到一半就报 "CUDA out of memory",GPU 显存直接炸掉。我一开始以为是 offload 参数没开,加了 --offload_model True 之后还是爆,反复调 convert_model_dtype 也没用。
原因:A14B 是 MoE 架构,参数规模虽大但实际激活的只有一部分专家——但 MoE 模型加载时需要先把所有专家权重都加载进显存做初始计算,这一步的显存峰值远超你用 TI2V-5B 的预期。TI2V-5B 只需 24GB 显存就能跑文生视频,A14B 单卡 24GB 根本顶不住。
解法:有两条路。一条是退一步,TI2V-5B 文生视频效果跟 A14B 差不了太多,24GB 卡稳稳跑。另一条是上多卡,8 卡用 FSDP + Ulysses 并行,A14B 就能流畅跑 720P 了。单卡真想撑 A14B 的话,只能把分辨率降到 480P,还要开 CPU offload 和 VAE slicing,生成速度会慢不少。
第三个坑:Prompt 扩展不开启,视频细节全靠运气
症状:生成的视频画面空洞、动作不连贯,两只猫打拳击只看到轮廓,拳击手套的细节全没。换了好几个 prompt,要么画面太笼统要么动作对不上,我一度以为是模型本身效果就这样。
原因:Wan2.2 官方强烈建议开启 prompt 扩展。原始 prompt 通常比较短、比较概括,扩展会自动补充场景细节、光照、镜头语言等。我一开始嫌多一步配置麻烦没开,直接喂原始 prompt,生成质量打了对折。
解法:两种扩展方式。推荐用 DashScope 云端 API——去阿里云百炼控制台申请 DashScope API Key,设个环境变量,推理命令加 --use_prompt_extend --prompt_extend_method dashscope 就行。DashScope 有免费额度,超出按量计费,比自己下模型省空间。如果不想联网,也可以下 Qwen 系列模型本地扩展——但 7B 模型约 15GB,14B 约 28GB,还要额外占 GPU 显存,得自己权衡。
第四个坑:Diffusers 加载权重忘了加后缀
症状:用 Diffusers Pipeline 加载 Wan2.2 模型时报 RepositoryNotFoundError,说找不到我指定的模型仓库。反复核对仓库名、确认 HF 上存在、甚至换了镜像,一样报错。
原因:Wan2.2 全系列在 HuggingFace 上有两套权重——官方原生权重和 Diffusers 适配版本。加载 Diffusers Pipeline 时必须用带 -Diffusers 后缀的仓库名。我一开始写的是 "Wan-AI/Wan2.2-T2V-A14B",这是原生权重仓库,Diffusers Pipeline 不认。
解法:把仓库名改成 "Wan-AI/Wan2.2-T2V-A14B-Diffusers",加了 -Diffusers 后缀就对了。Pipeline 内部会自动处理 MoE 模型的高噪/低噪专家加载和 SNR 切换,不用手动管。TI2V-5B、Animate-14B 同理,仓库名都要带这个后缀。

第五个坑:多卡命令和单卡参数混用
症状:照着网上看到的多卡教程敲命令,结果 offload 参数和 FSDP 参数一起用,要么报参数冲突,要么跑起来巨慢——多卡反而比单卡还卡。
原因:单卡和多卡的命令参数是两套思路。单卡需要 --offload_model True 把模型层卸载到 CPU 省显存、--convert_model_dtype 转 bfloat16 减显存。但多卡用 FSDP(Fully Sharded Data Parallel)分片模型权重,--ulysses_size 8 做序列并行,这时候再加 offload 反而会拖垮速度——分片之后各卡自己的显存已经够了,offload 变成了多余的 CPU-GPU 数据搬运。
解法:单卡就用单卡参数,多卡就用多卡参数,别混。单卡模板:--offload_model True --convert_model_dtype,多卡模板:--dit_fsdp --t5_fsdp --ulysses_size 8,两套互斥。

要点速查
- FlashAttention 最后单独装,先装完其他依赖再碰它
- 24GB 显存选 TI2V-5B,A14B 至少要多卡或更高显存
- Prompt 扩展默认开启,DashScope 云端比本地省事儿
- Diffusers Pipeline 权重仓库名必须带
-Diffusers后缀 - 单卡参数和多卡 FSDP/Ulysses 参数别混用
避完这些坑,Wan2.2 真的是目前开源文生视频里效果最扎实的选择——只要环境搭对、参数选准,从一句 prompt 到一段 720P 视频也就几分钟的事。
本文为个人基于网络公开资料整理编写,非官方内容,仅供学习交流参考;软件版权归原作者所有,请支持正版;使用过程中遇到问题请查阅官方渠道,本文不承担任何责任。